見かけ上無関係な回帰 とは
見かけ上無関係な回帰(Seemingly Unrelated Regressions, SUR)は、複数の回帰式を一つのシステムとして同時に推定する方法です。
各式は、被説明変数・説明変数・係数がそれぞれ別々ですので、一見すると互いに無関係に見えます。
しかし、同じ時点の誤差項が式の間で相関していると、各式を個別に推定するだけでは、その相関という情報を捨ててしまうことになります。
SUR は、この誤差項の式間相関を利用して、係数をより効率よく推定します。
たとえば、同じ年の景気ショックが複数の産業の投資に同時に影響するような状況が典型例です。
モデル
\(M\) 本の回帰式を考えます。
\[\begin{eqnarray}
y_{it} &=& \boldsymbol{x}_{it}^{\top}\boldsymbol{\beta}_i + \varepsilon_{it} \qquad (i = 1, \dots, M;\ t = 1, \dots, T)
\end{eqnarray}\]
- \(i\)
- 式の番号(\(M\) は式の数)
- \(t\)
- 時点の番号(\(T\) は観測数)
- \(y_{it}\)
- 第 \(i\) 式の第 \(t\) 時点の被説明変数
- \(\boldsymbol{x}_{it}\)
- 第 \(i\) 式の説明変数ベクトル(\(k_i\) 次元。式ごとに異なってよい)
- \(\boldsymbol{\beta}_i\)
- 第 \(i\) 式の係数ベクトル(\(k_i\) 次元)
- \(\varepsilon_{it}\)
- 第 \(i\) 式の第 \(t\) 時点の誤差項
誤差項は、同じ時点であれば式の間で相関し、異なる時点の間では無相関であると仮定します。
\[\begin{eqnarray}
E[\varepsilon_{it}\,\varepsilon_{js}] &=& \sigma_{ij} \quad (t = s) \\
E[\varepsilon_{it}\,\varepsilon_{js}] &=& 0 \quad (t \neq s)
\end{eqnarray}\]
- \(\sigma_{ij}\) : 第 \(i\) 式と第 \(j\) 式の誤差項の共分散(\(\sigma_{ii}\) は第 \(i\) 式の誤差分散)
式ごとに時点を縦に積んで、さらに全ての式を縦に積み上げると、次のように書けます。
\[\begin{eqnarray}
\boldsymbol{y}_i &=& \boldsymbol{X}_i\boldsymbol{\beta}_i + \boldsymbol{\varepsilon}_i \\
\boldsymbol{y} &=& \boldsymbol{X}\boldsymbol{\beta} + \boldsymbol{\varepsilon} \\
\mathrm{Var}(\boldsymbol{\varepsilon}) &=& \boldsymbol{\Sigma}\otimes\boldsymbol{I}_T
\end{eqnarray}\]
- \(\boldsymbol{y}_i\)
- 第 \(i\) 式の被説明変数を縦に並べた \(T\) 次元ベクトル
- \(\boldsymbol{X}_i\)
- 第 \(i\) 式の説明変数行列(\(T \times k_i\))
- \(\boldsymbol{\varepsilon}_i\)
- 第 \(i\) 式の誤差項を縦に並べた \(T\) 次元ベクトル
- \(\boldsymbol{y} = (\boldsymbol{y}_1^{\top}, \dots, \boldsymbol{y}_M^{\top})^{\top}\)
- 全ての式の被説明変数を積み上げたベクトル
- \(\boldsymbol{X} = \mathrm{diag}(\boldsymbol{X}_1, \dots, \boldsymbol{X}_M)\)
- \(\boldsymbol{X}_i\) を対角ブロックに並べた行列
- \(\boldsymbol{\beta} = (\boldsymbol{\beta}_1^{\top}, \dots, \boldsymbol{\beta}_M^{\top})^{\top}\)
- 全ての係数を積み上げたベクトル
- \(\boldsymbol{\varepsilon} = (\boldsymbol{\varepsilon}_1^{\top}, \dots, \boldsymbol{\varepsilon}_M^{\top})^{\top}\)
- 全ての誤差項を積み上げたベクトル
- \(\boldsymbol{\Sigma} = (\sigma_{ij})\)
- 式間の誤差共分散行列(\(M \times M\))
- \(\otimes\)
- クロネッカー積
- \(\boldsymbol{I}_T\)
- \(T\) 次の単位行列
推定方法
\(\boldsymbol{\Sigma}\) が既知であれば、一般化最小二乗法(GLS)で推定します。
\[\begin{eqnarray}
\hat{\boldsymbol{\beta}}_{\mathrm{GLS}} &=& \left(\boldsymbol{X}^{\top}(\boldsymbol{\Sigma}^{-1}\otimes\boldsymbol{I}_T)\boldsymbol{X}\right)^{-1}\boldsymbol{X}^{\top}(\boldsymbol{\Sigma}^{-1}\otimes\boldsymbol{I}_T)\boldsymbol{y} \\
\mathrm{Var}(\hat{\boldsymbol{\beta}}_{\mathrm{GLS}}) &=& \left(\boldsymbol{X}^{\top}(\boldsymbol{\Sigma}^{-1}\otimes\boldsymbol{I}_T)\boldsymbol{X}\right)^{-1}
\end{eqnarray}\]
- \(\hat{\boldsymbol{\beta}}_{\mathrm{GLS}}\)
- 係数のGLS推定量
- \(\boldsymbol{\Sigma}^{-1}\)
- \(\boldsymbol{\Sigma}\) の逆行列
現実には \(\boldsymbol{\Sigma}\) は未知ですので、次の3段階で推定します(実行可能GLS、FGLS)。
- 各式を最小二乗法(OLS)で別々に推定し、残差 \(\boldsymbol{e}_i\) を得る。
- 残差から \(\hat{\sigma}_{ij} = \boldsymbol{e}_i^{\top}\boldsymbol{e}_j / T\) を計算して \(\hat{\boldsymbol{\Sigma}}\) をつくる。
- \(\boldsymbol{\Sigma}\) を \(\hat{\boldsymbol{\Sigma}}\) に置き換えて GLS の式を計算する。
式ごとのOLSと一致する場合、差が出る場合
SUR の推定値が式ごとの OLS と完全に一致するのは、次の2つの場合です。
- 誤差の式間共分散がすべて 0 である(\(\sigma_{ij} = 0,\ i \neq j\))。
- 全ての式の説明変数が同じである(\(\boldsymbol{X}_1 = \dots = \boldsymbol{X}_M\))。
それ以外の場合は、SUR のほうが分散の小さい推定量になります。
改善の大きさは、「回帰式が2本」かつ「各式に定数項と説明変数1つ(説明変数は標本平均を引いて中心化)」の場合ですと、傾きの分散比として次のように書けます(\(\boldsymbol{\Sigma}\) が既知のとき)。
\[\begin{eqnarray}
\frac{\mathrm{Var}(\hat{\beta}_{11}^{\mathrm{GLS}})}{\mathrm{Var}(\hat{\beta}_{11}^{\mathrm{OLS}})} &=& \frac{1 - \rho^2}{1 - \rho^2 r^2}
\end{eqnarray}\]
- \(\hat{\beta}_{11}\)
- 2本の回帰式のうち第1式の傾きの推定量
- \(\rho = \sigma_{12}/\sqrt{\sigma_{11}\sigma_{22}}\)
- 2本の回帰式それぞれの誤差の間の相関係数
- \(r\)
- 2本の回帰式の説明変数(中心化後)の間の標本相関係数
この式から、誤差の相関 \(|\rho|\) が大きいほど、また、式の間で説明変数の相関 \(|r|\) が小さいほど、SUR による改善が大きいことが読み取れます。
\(\rho = 0\) または \(|r| = 1\) のとき、比は 1(=改善なし)になります。
注意点
- 誤差の相関は「同じ時点どうし」の式間相関です。時点をまたぐ相関(系列相関)は別の問題です。
- 説明変数が誤差項と相関している(内生性がある)場合、SUR でも一致推定量は得られません。その場合は三段階最小二乗法(3SLS)などを使います。
- \(\hat{\boldsymbol{\Sigma}}\) を安定して推定するため、観測数 \(T\) は式の数 \(M\) や各式の説明変数の数に比べて十分大きい必要があります。
Rコード
ここでは、SUR の仕組みを次の順に確かめます。
- 誤差が式間で相関しているデータを作成し、その誤差相関を確認します。
- SUR(FGLS)を行列計算で一から実装し、OLS と比べます。
- OLS と完全に一致する場合を確かめます。
- モンテカルロ実験で、効率改善の大きさが \(\rho\) と \(r\) でどう変わるかを調べます。
- SUR で可能になる、式をまたぐ係数の制約の検定を行います。
データ生成
2式のシステムを考えます。
\[\begin{eqnarray}
y_{1t} &=& \beta_{10} + \beta_{11}x_{1t} + \varepsilon_{1t} \\
y_{2t} &=& \beta_{20} + \beta_{21}x_{2t} + \varepsilon_{2t}
\end{eqnarray}\]
- \(y_{it}\)
- 第 \(i\) 式の被説明変数
- \(x_{it}\)
- 第 \(i\) 式の説明変数
- \(\beta_{i0}\), \(\beta_{i1}\)
- 第 \(i\) 式の切片と傾き
- \(\varepsilon_{it}\)
- 誤差項。\((\varepsilon_{1t}, \varepsilon_{2t})\) は平均 0、共分散行列 \(\boldsymbol{\Sigma}\) の正規分布に従う。
真の値は \((\beta_{10}, \beta_{11}) = (1, 2)\)、\((\beta_{20}, \beta_{21}) = (-1, 3)\)、誤差の分散は 1、誤差の相関は \(\rho = 0.8\) とします。
library(ggplot2)

set.seed(20261026)

n_obs <- 50
beta1_true <- c(1, 2)
beta2_true <- c(-1, 3)
rho_true <- 0.8
sigma_true <- matrix(c(1, rho_true, rho_true, 1), nrow = 2)

# 中心化した2本の説明変数をつくる関数
# 2本の標本相関係数は r_x にちょうど一致する
make_x <- function(n_obs, r_x) {
  z1 <- rnorm(n_obs)
  z2 <- rnorm(n_obs)
  z1 <- z1 - mean(z1)
  # z2 から z1 に比例する成分を取り除き、z1 と直交させる
  z2 <- resid(lm(z2 ~ z1))
  u1 <- z1 / sqrt(sum(z1^2))
  u2 <- z2 / sqrt(sum(z2^2))
  list(
    x1 = sqrt(n_obs) * u1,
    x2 = sqrt(n_obs) * (r_x * u1 + sqrt(1 - r_x^2) * u2)
  )
}

# 共分散行列 sigma をもつ2本の誤差項(n_obs 行 x 2 列)をつくる関数
make_errors <- function(n_obs, sigma) {
  z <- matrix(rnorm(n_obs * 2), nrow = n_obs, ncol = 2)
  z %*% chol(sigma)
}

# 説明変数の相関を 0.3 として1組のデータをつくる
xd <- make_x(n_obs, r_x = 0.3)
x_mat1 <- cbind(const = 1, x = xd$x1)
x_mat2 <- cbind(const = 1, x = xd$x2)

err <- make_errors(n_obs, sigma_true)
y1 <- drop(x_mat1 %*% beta1_true) + err[, 1]
y2 <- drop(x_mat2 %*% beta2_true) + err[, 2]
SUR(FGLS)の実装
推定方法 の3段階を、そのまま関数にします。
GLS の式の \(\boldsymbol{\Sigma}^{-1}\otimes\boldsymbol{I}_T\) も、kronecker() で明示的に組み立てます。
# SUR(1段階のFGLS)を行列計算で実装する関数
# y_list : 各式の被説明変数ベクトルのリスト
# x_list : 各式の説明変数行列のリスト
# diagonal_only : TRUE のとき、誤差共分散の非対角要素を 0 とみなす
sur_fgls <- function(y_list, x_list, diagonal_only = FALSE) {
  n_eq <- length(y_list)
  n_obs <- length(y_list[[1]])
  n_par <- vapply(x_list, ncol, integer(1))

  # 手順1: 式ごとにOLSで推定し、係数と残差を得る
  fit_ols <- Map(function(y, x) lm.fit(x, y), y_list, x_list)
  coef_ols <- unlist(lapply(fit_ols, `[[`, "coefficients"))
  resid_mat <- sapply(fit_ols, `[[`, "residuals")

  # 手順2: 残差から誤差共分散行列を推定する(T で割る)
  sigma_hat <- crossprod(resid_mat) / n_obs
  if (diagonal_only) {
    sigma_hat <- diag(diag(sigma_hat), nrow = n_eq)
  }

  # 手順3: 積み上げた y と、対角ブロックの X をつくる
  y_all <- unlist(y_list)
  x_all <- matrix(0, nrow = n_obs * n_eq, ncol = sum(n_par))
  col_start <- c(0, cumsum(n_par))
  for (i in seq_len(n_eq)) {
    row_idx <- (i - 1) * n_obs + seq_len(n_obs)
    col_idx <- col_start[i] + seq_len(n_par[i])
    x_all[row_idx, col_idx] <- x_list[[i]]
  }

  # GLS の式を計算する
  omega_inv <- kronecker(solve(sigma_hat), diag(n_obs))
  xt_oi <- t(x_all) %*% omega_inv
  vcov_gls <- solve(xt_oi %*% x_all)
  coef_gls <- drop(vcov_gls %*% xt_oi %*% y_all)

  par_names <- unlist(lapply(seq_len(n_eq), function(i) {
    paste0("eq", i, "_", colnames(x_list[[i]]))
  }))
  names(coef_gls) <- par_names
  names(coef_ols) <- par_names
  dimnames(vcov_gls) <- list(par_names, par_names)

  # 比較のため、OLSの標準誤差も同じ sigma_hat(T で割る)から計算する
  se_ols <- unlist(lapply(seq_len(n_eq), function(i) {
    sqrt(diag(sigma_hat[i, i] * solve(crossprod(x_list[[i]]))))
  }))
  names(se_ols) <- par_names

  list(
    coef = coef_gls, vcov = vcov_gls, sigma = sigma_hat,
    coef_ols = coef_ols, se_ols = se_ols, resid = resid_mat
  )
}
誤差の相関を確かめる
式ごとにOLSで推定した残差を散布図にします。
式の間で残差が同じ方向に動いていれば、SUR を使う余地があります。
fit_demo <- sur_fgls(list(y1, y2), list(x_mat1, x_mat2))

resid_df <- data.frame(e1 = fit_demo$resid[, 1], e2 = fit_demo$resid[, 2])
rho_hat <- cor(resid_df$e1, resid_df$e2)

ggplot(resid_df, aes(x = e1, y = e2)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  labs(
    x = "第1式のOLS残差",
    y = "第2式のOLS残差",
    title = sprintf("残差の相関係数 = %.3f(真の値 = %.1f)", rho_hat, rho_true)
  )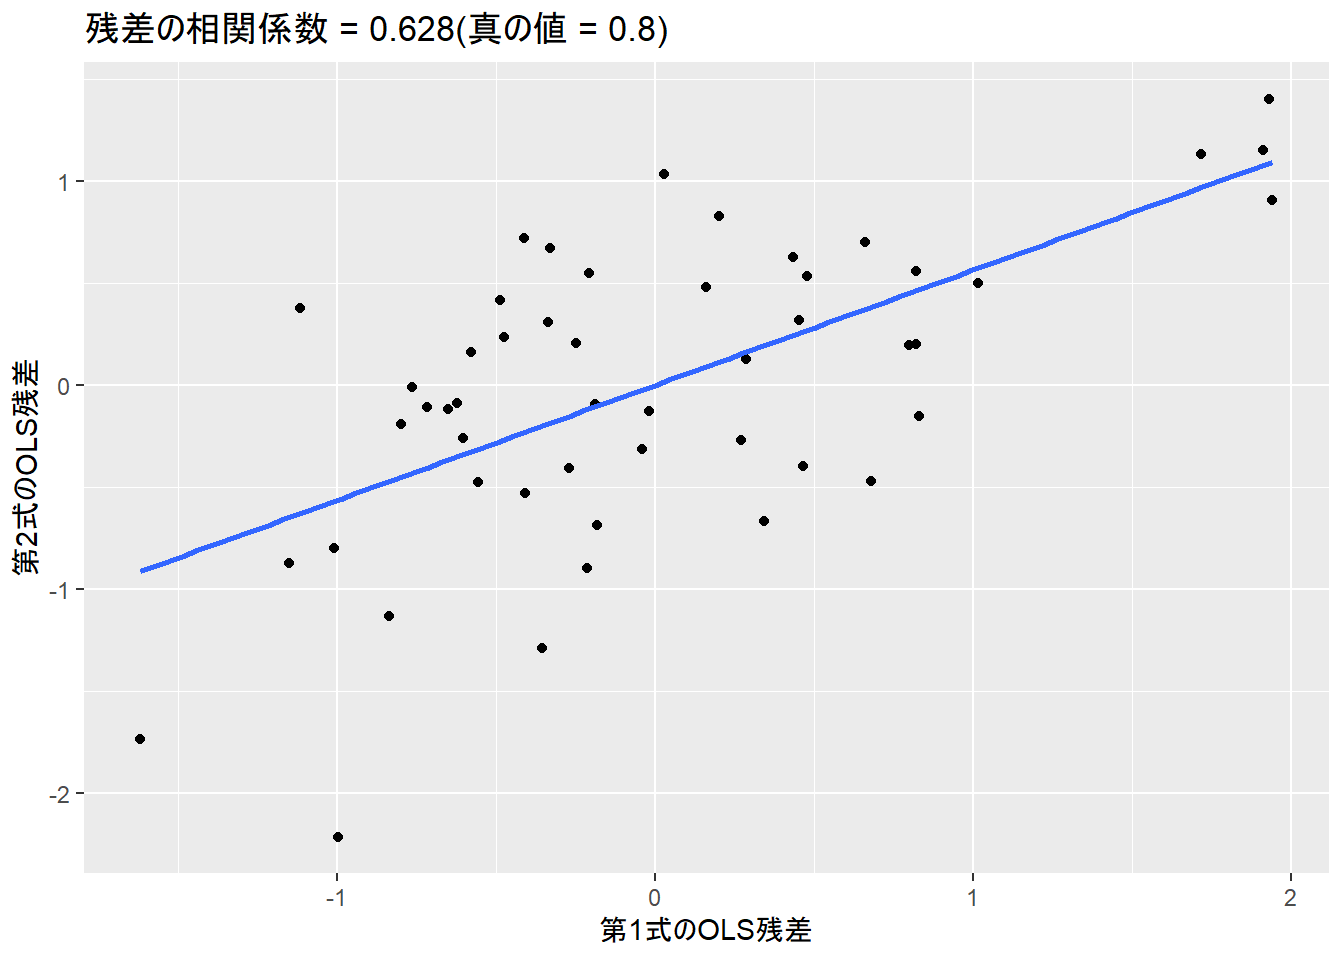
- 散布図が右上がりの傾向を示している。
- 第1式の残差が正のとき、第2式の残差も正になりやすく、負のときは負になりやすい、という関係が点の全体に見えます。青い回帰直線も右上がりです。一部の外れ値が引っ張っているのではなく、雲全体が同じ向きに並んでいます。
- 相関係数が 0.628 と大きい。
- 誤差が無相関(\(\rho = 0\))なら、50個の標本で0.6以上の値になることは考えにくいです。この相関係数を検定の統計量(t 値)にすると約 5.6 になり、p 値は 1e-6 程度です。
よって、2式の間でOLSの残差が連動していると判断します。
OLSとSURの推定結果を比べる
result_table <- data.frame(
  true = c(beta1_true, beta2_true),
  ols = fit_demo$coef_ols,
  se_ols = fit_demo$se_ols,
  sur = fit_demo$coef,
  se_sur = sqrt(diag(fit_demo$vcov))
)
result_table$se_ratio <- result_table$se_sur / result_table$se_ols

knitr::kable(result_table, digits = 3)| true | ols | se_ols | sur | se_sur | se_ratio | |
|---|---|---|---|---|---|---|
| eq1_const | 1 | 1.065 | 0.115 | 1.065 | 0.115 | 1.000 |
| eq1_x | 2 | 2.090 | 0.115 | 2.027 | 0.091 | 0.793 |
| eq2_const | -1 | -0.987 | 0.103 | -0.987 | 0.103 | 1.000 |
| eq2_x | 3 | 3.315 | 0.103 | 3.169 | 0.082 | 0.793 |
- 傾きでは SUR のほうが精度が高い
-
eq1_xとeq2_xの標準誤差は、OLS の 0.115, 0.103 から、SUR では 0.091, 0.082 に下がっています。se_ratioは 0.793 で、OLS の約 8 割です。式の間で誤差が相関していますので、その情報を使った SUR のほうが効率的になります。
-
- 切片では OLS と SUR に差がない
-
eq1_constとeq2_constは、係数も標準誤差も同じです(se_ratioは 1.000)。どちらの式でも、切片に対応する説明変数は同じ定数項(全て 1 の列)であるためです。改善が出るのは、式の間で説明変数が異なる傾きの側です。
-
- 点推定の違いは小さく、1回の標本で優劣は決まらない
- 傾きの推定値は、OLS が 2.090 と 3.315、SUR が 2.027 と 3.169 になり、この標本ではSURのほうが真の値(2 と 3)に近くなっています。ただし、どちらも不偏ですので、これは偶然の可能性があります。SUR の利点は、点推定が毎回真の値に近づくことではなく、推定のばらつき(標準誤差)が小さくなることです。
なお、se_ratio の 0.793 は、OLS 残差の間の相関 \(\hat{\rho} \approx 0.63\) と、説明変数の間の相関 \(r = 0.3\) から計算した値と一致します。
# 誤差共分散行列の推定値から、残差の相関係数 rho_hat_sigma を計算する
sigma_hat <- fit_demo$sigma
rho_hat_sigma <- sigma_hat[1, 2] / sqrt(sigma_hat[1, 1] * sigma_hat[2, 2])

# 2本の説明変数(中心化後)の標本相関係数 r を計算する
r_hat <- cor(xd$x1, xd$x2)

# 理論式から標準誤差の比を計算する
se_ratio_theory <- sqrt((1 - rho_hat_sigma^2) / (1 - rho_hat_sigma^2 * r_hat^2))

data.frame(
  rho_hat = c(rho_hat_sigma, rho_hat),
  r = r_hat,
  se_ratio_theory = se_ratio_theory,
  se_ratio_table = result_table["eq1_x", "se_ratio"]
)
rho_hat r se_ratio_theory se_ratio_table
1 0.6276329 0.3 0.7926879 0.7926879
2 0.6276329 0.3 0.7926879 0.7926879# 2本の傾きの標準誤差の比と、理論式の値との差
abs(result_table[c("eq1_x", "eq2_x"), "se_ratio"] - se_ratio_theory)[1] 2.220446e-16 0.000000e+00推定された誤差共分散行列も確認します。
fit_demo$sigma [,1] [,2]
[1,] 0.6560179 0.3700903
[2,] 0.3700903 0.5300153既存パッケージの結果との照合
systemfit パッケージの SUR と、自作関数の結果が一致するか確かめます。
methodResidCov = "noDfCor" は、共分散行列の推定で \(T\) で割る方法です。
if (requireNamespace("systemfit", quietly = TRUE)) {
  dat <- data.frame(y1 = y1, y2 = y2, x1 = xd$x1, x2 = xd$x2)
  fit_sf <- systemfit::systemfit(
    list(eq1 = y1 ~ x1, eq2 = y2 ~ x2),
    method = "SUR", data = dat, methodResidCov = "noDfCor"
  )
  cat(
    "係数の差の最大値:",
    format(max(abs(coef(fit_sf) - fit_demo$coef)), digits = 3), "\n"
  )
  cat(
    "分散共分散行列の差の最大値:",
    format(max(abs(vcov(fit_sf) - fit_demo$vcov)), digits = 3), "\n"
  )
} else {
  cat("systemfit パッケージが未インストールのため、照合を省略します。\n")
}
係数の差の最大値: 3.11e-15
分散共分散行列の差の最大値: 2.95e-17 自作関数 sur_fgls() の結果は、systemfit パッケージの SUR と一致しました。
係数の差の最大値は 3.11e-15、分散共分散行列の差の最大値は 2.95e-17 と、どちらも計算機の丸め誤差の範囲(実質的に 0)です。
一致しましたのは、両者が同じ手順で計算しているためです。
- 各式を OLS で推定し、残差を得る。
- 残差から \(\hat{\boldsymbol{\Sigma}}\) を求める。
- \(\hat{\boldsymbol{\Sigma}}\) を使って GLS の式を計算する。
methodResidCov = "noDfCor" は、手順2で \(T\) で割る設定です。
自作関数の \(\hat{\sigma}_{ij} = \boldsymbol{e}_i^{\top}\boldsymbol{e}_j / T\) と揃えるために指定しています。
係数だけでなく、標準誤差のもとになる分散共分散行列も一致していますので、行列計算による実装は正しいと言えます。
OLSと完全に一致する場合
解説で述べた2つの場合を、実際に計算して確かめます。
# 場合1: 誤差共分散の非対角要素を 0 とみなす
fit_diag <- sur_fgls(
  list(y1, y2), list(x_mat1, x_mat2),
  diagonal_only = TRUE
)

# 場合2: 両方の式に同じ説明変数を使う
fit_same_x <- sur_fgls(list(y1, y2), list(x_mat1, x_mat1))

data.frame(
  case = c("非対角要素を0とみなす", "説明変数が同じ"),
  max_abs_diff = c(
    max(abs(fit_diag$coef - fit_diag$coef_ols)),
    max(abs(fit_same_x$coef - fit_same_x$coef_ols))
  )
) |>
knitr::kable(digits = 15)| case | max_abs_diff |
|---|---|
| 非対角要素を0とみなす | 1e-15 |
| 説明変数が同じ | 2e-15 |
どちらの場合も、SUR と OLS の係数の差は 1e-15 から 2e-15 程度で、計算機の丸め誤差の範囲(実質的に 0)です。
式ごとのOLSと一致する場合、差が出る場合で述べた、SUR が OLS と完全に一致する2つの場合が、数値で確かめられました。
- 非対角要素を 0 とみなす場合
- \(\hat{\boldsymbol{\Sigma}}\) が対角行列になると、GLS の式は式ごとの計算に分かれます。各式の誤差分散は式の中で約分されますので、結果は OLS と同じです。
- 説明変数が同じ場合
- 全ての式で説明変数が同じ \(\boldsymbol{X}_1\) なら、式を整理すると \(\hat{\boldsymbol{\Sigma}}\) が打ち消され、OLS の式 \((\boldsymbol{X}_1^{\top}\boldsymbol{X}_1)^{-1}\boldsymbol{X}_1^{\top}\boldsymbol{y}_i\) に一致します。
モンテカルロ実験: 効率改善の大きさ
誤差の相関 \(\rho\) と説明変数の相関 \(r\) を変えながら、データ生成と推定を繰り返し、第1式の傾き \(\hat{\beta}_{11}\) の分散を OLS と SUR で比べます。
説明変数は繰り返しのあいだ固定し、誤差だけを毎回引き直します。
理論式の比 \((1-\rho^2)/(1-\rho^2 r^2)\) とも照らし合わせます。
n_rep <- 2000
rho_grid <- c(0, 0.3, 0.6, 0.9)
rx_grid <- c(0, 0.5, 0.9)

# 1つの条件(rho, r_x)について n_rep 回の推定を行う関数
simulate_one <- function(rho, r_x, n_rep, n_obs) {
  xd <- make_x(n_obs, r_x)
  x_mat1 <- cbind(const = 1, x = xd$x1)
  x_mat2 <- cbind(const = 1, x = xd$x2)
  sigma <- matrix(c(1, rho, rho, 1), nrow = 2)

  est <- t(replicate(n_rep, {
    err <- make_errors(n_obs, sigma)
    y1 <- drop(x_mat1 %*% beta1_true) + err[, 1]
    y2 <- drop(x_mat2 %*% beta2_true) + err[, 2]
    fit <- sur_fgls(list(y1, y2), list(x_mat1, x_mat2))
    c(ols = fit$coef_ols[["eq1_x"]], sur = fit$coef[["eq1_x"]])
  }))

  data.frame(
    rho = rho, r_x = r_x,
    mean_ols = mean(est[, "ols"]), mean_sur = mean(est[, "sur"]),
    var_ols = var(est[, "ols"]), var_sur = var(est[, "sur"])
  )
}

conditions <- expand.grid(rho = rho_grid, r_x = rx_grid)
sim_res <- do.call(rbind, lapply(seq_len(nrow(conditions)), function(k) {
  simulate_one(conditions$rho[k], conditions$r_x[k], n_rep, n_obs)
}))
sim_res$ratio_mc <- sim_res$var_sur / sim_res$var_ols
sim_res$ratio_theory <- (1 - sim_res$rho^2) / (1 - sim_res$rho^2 * sim_res$r_x^2)

knitr::kable(sim_res, digits = 3)| rho | r_x | mean_ols | mean_sur | var_ols | var_sur | ratio_mc | ratio_theory |
|---|---|---|---|---|---|---|---|
| 0.0 | 0.0 | 2.002 | 2.002 | 0.020 | 0.020 | 1.007 | 1.000 |
| 0.3 | 0.0 | 1.996 | 1.995 | 0.019 | 0.017 | 0.921 | 0.910 |
| 0.6 | 0.0 | 2.006 | 2.003 | 0.020 | 0.013 | 0.657 | 0.640 |
| 0.9 | 0.0 | 1.999 | 2.000 | 0.019 | 0.004 | 0.193 | 0.190 |
| 0.0 | 0.5 | 1.999 | 1.999 | 0.019 | 0.020 | 1.006 | 1.000 |
| 0.3 | 0.5 | 2.001 | 2.001 | 0.019 | 0.018 | 0.942 | 0.931 |
| 0.6 | 0.5 | 1.997 | 1.999 | 0.020 | 0.015 | 0.721 | 0.703 |
| 0.9 | 0.5 | 2.004 | 2.001 | 0.019 | 0.005 | 0.245 | 0.238 |
| 0.0 | 0.9 | 1.998 | 1.998 | 0.020 | 0.020 | 1.004 | 1.000 |
| 0.3 | 0.9 | 2.002 | 2.002 | 0.021 | 0.021 | 0.984 | 0.982 |
| 0.6 | 0.9 | 1.997 | 1.998 | 0.020 | 0.019 | 0.918 | 0.903 |
| 0.9 | 0.9 | 2.001 | 2.003 | 0.020 | 0.012 | 0.576 | 0.552 |
- 不偏性は OLS・SUR ともに保たれている
-
mean_olsとmean_surは、どの条件でも真の値 \(\beta_{11} = 2\) に近い値(1.995 から 2.006)です。SUR で変わるのは平均ではなく、分散です。
-
- 分散比は理論式とほぼ一致する
-
ratio_mcは、理論式 \((1-\rho^2)/(1-\rho^2 r^2)\) の値ratio_theoryに近い値になっています。たとえば \(\rho = 0.9,\ r = 0\) では、実験値が 0.193、理論値が 0.190 です。
-
- 改善の大きさは \(\rho\) と \(r\) で決まる
- \(\rho\) が大きいほど、分散比は小さくなります(\(r = 0\) の行で 1.007 → 0.921 → 0.657 → 0.193)。
- \(r\) が大きいほど、改善は小さくなります(\(\rho = 0.9\) の行で 0.193 → 0.245 → 0.576)。
- \(\rho = 0\) では、分散比は約 1 で、改善はありません。
- 実験値は理論値よりわずかに大きい
- 理論式は \(\boldsymbol{\Sigma}\) が既知のときの式ですが、実際の SUR は推定した \(\hat{\boldsymbol{\Sigma}}\) を使います。その推定誤差のぶん、分散がわずかに増えるためです。\(\rho = 0\) で 1.00 をわずかに上回るのも、同じ理由です。
rho_fine <- seq(0, 0.95, length.out = 100)
theory_df <- expand.grid(rho = rho_fine, r_x = rx_grid)
theory_df$ratio_theory <- (1 - theory_df$rho^2) /
  (1 - theory_df$rho^2 * theory_df$r_x^2)

ggplot() +
  geom_line(
    data = theory_df,
    aes(x = rho, y = ratio_theory, color = factor(r_x))
  ) +
  geom_point(
    data = sim_res,
    aes(x = rho, y = ratio_mc, color = factor(r_x)),
    size = 2.5
  ) +
  labs(
    x = "誤差の相関係数 ρ",
    y = "分散比(SUR / OLS)",
    color = "説明変数の相関 r",
    title = "SURとOLSの分散比(点: モンテカルロ、線: 理論式)"
  )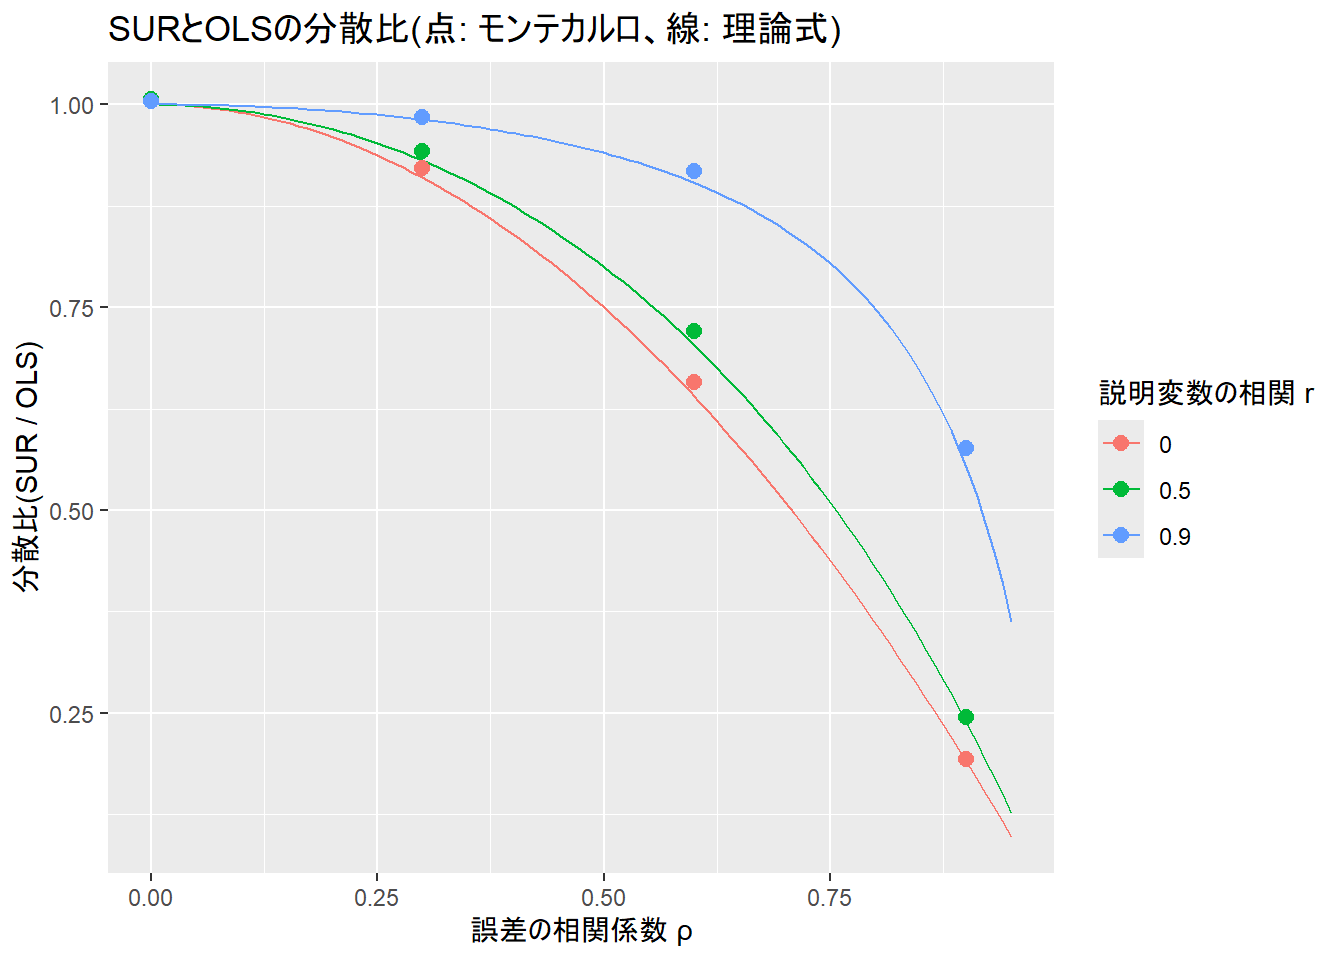
線は理論式 \((1-\rho^2)/(1-\rho^2 r^2)\)、点はモンテカルロ実験の結果です。
縦軸の分散比は、1 より小さいほど SUR が OLS より効率的なことを表します。
- \(\rho\) が大きいほど改善が大きい
- どの線も、\(\rho = 0\) で 1 から始まり、\(\rho\) が大きくなるほど下がります。\(r = 0\) の赤線では、\(\rho = 0.9\) で分散比が約 0.2 になります。
- \(r\) が大きいほど改善が小さい
- 同じ \(\rho\) なら、\(r = 0\)(赤)、\(0.5\)(緑)、\(0.9\)(青)の順に分散比が高くなります。式の間で説明変数が似ているほど、SUR の利点は小さくなります。
- 点は線の近くに並ぶ
- 実験結果が理論式にほぼ従っていますので、\(\frac{\mathrm{Var}(\hat{\beta}_{11}^{\mathrm{GLS}})}{\mathrm{Var}(\hat{\beta}_{11}^{\mathrm{OLS}})} = \frac{1 - \rho^2}{1 - \rho^2 r^2}\) が妥当であることを示唆します。
- 点は線のわずかに上に出る傾向がある
- 理論式は \(\boldsymbol{\Sigma}\) が既知のときの式です。実際の SUR は推定した \(\hat{\boldsymbol{\Sigma}}\) を使いますので、その推定誤差の分だけ分散が増えます。
式をまたぐ係数の制約の検定
SUR では、2式の推定量の共分散も得られるため、式をまたぐ制約を検定できます。
ここでは「2式の傾きが等しい」(\(\beta_{11} = \beta_{21}\))という帰無仮説を、ワルド検定で調べます。
\[\begin{eqnarray}
W &=& (\boldsymbol{R}\hat{\boldsymbol{\beta}} - q)^{\top}\left(\boldsymbol{R}\hat{\boldsymbol{V}}\boldsymbol{R}^{\top}\right)^{-1}(\boldsymbol{R}\hat{\boldsymbol{\beta}} - q)
\end{eqnarray}\]
- \(\boldsymbol{R}\)
- 制約を表す行列。ここでは \(\boldsymbol{\beta} = (\beta_{10}, \beta_{11}, \beta_{20}, \beta_{21})^{\top}\) に対して \(\boldsymbol{R} = (0, 1, 0, -1)\)
- \(q\)
- 制約の右辺(ここでは 0)
- \(\hat{\boldsymbol{V}}\)
- SUR 推定量の分散共分散行列
- \(W\)
- ワルド統計量。帰無仮説のもとで、漸近的に、制約の個数(ここでは1)をパラメータとする \(\chi^2\) 分布に従う
r_mat <- matrix(c(0, 1, 0, -1), nrow = 1)
q_vec <- 0

diff_hat <- r_mat %*% fit_demo$coef - q_vec
v_diff <- r_mat %*% fit_demo$vcov %*% t(r_mat)
wald_stat <- drop(t(diff_hat) %*% solve(v_diff) %*% diff_hat)
p_value <- pchisq(wald_stat, df = nrow(r_mat), lower.tail = FALSE)

data.frame(
  slope_diff = drop(diff_hat),
  wald_stat = wald_stat,
  p_value = format(p_value, digits = 3, scientific = TRUE)
) |>
knitr::kable(digits = 4)| slope_diff | wald_stat | p_value |
|---|---|---|
| -1.1413 | 107.5195 | 3.43e-25 |
2本の回帰式の傾きが等しいという帰無仮説(\(\beta_{11} = \beta_{21}\))を、ワルド検定で調べました。
- 傾きの差の推定値は -1.14
- 第1式の傾きから第2式の傾きを引いた値です。前の表の SUR の推定値(2.027 − 3.169)と一致します。真の差は 2 − 3 = −1 です。
- 帰無仮説は棄却される
- ワルド統計量は 107.5、p 値は 3.43e-25 ですので、有意水準5%で棄却されます。2式の傾きは等しくないと判断できます。標準誤差に直すと、差の標準誤差は約 0.11(\(= 1.1413/\sqrt{107.5}\))で、差はその約 10 倍です。
- SUR だから式をまたぐ検定ができる
- 差の分散は、各式の傾きの分散に加えて、2式の傾きの推定量の共分散も使って求めます。SUR は式をまとめて推定するので、この共分散が得られます。式ごとに OLS をすると、共分散が得られず、このような検定を直は接行えません。
以上です。